项目记录 / 联邦学习
基于联邦学习的
口罩识别系统.
从已有口罩识别基线出发,我参与搭建了 Flower 多客户端训练模拟,并在小组项目基础上独立撰写论文,研究客户端数量与本地训练轮数对准确率和训练耗时的影响。
从本地训练到全局评估。
- 01
客户端本地训练
各客户端在本地数据分区训练轻量 CNN
- 02
服务器聚合
基于 FedAvg 聚合更新,保存全局模型与训练指标
- 03
独立测试集评估
用未参与训练的图像评估全局模型的损失与准确率
01 / 小组阶段
将口罩识别基线扩展为联邦训练。
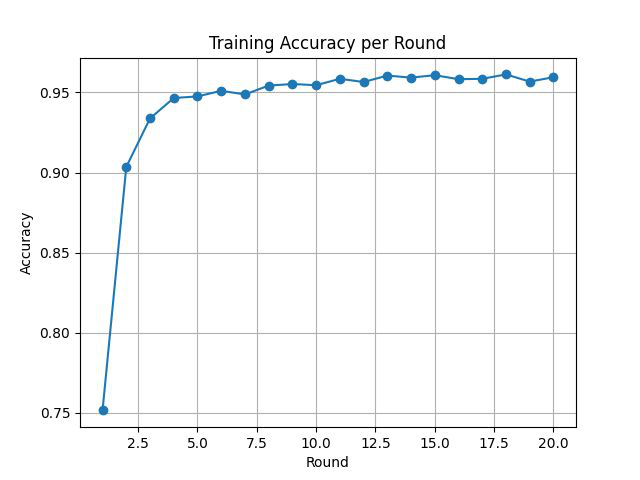
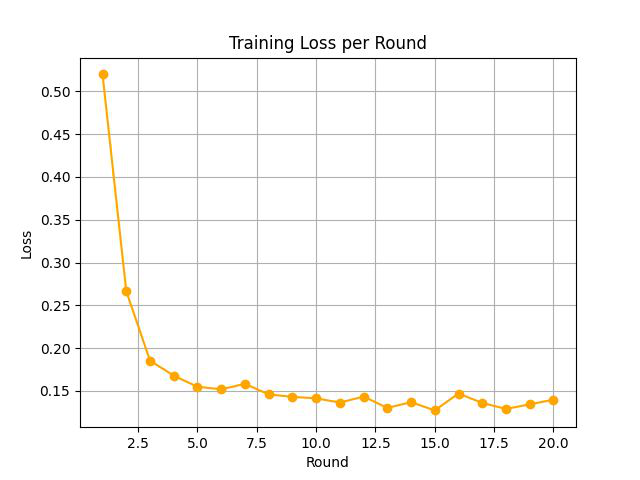
团队以已有的口罩识别项目为基线,用 PyTorch 构建轻量 CNN,对佩戴口罩和未佩戴口罩的图像进行二分类,再用 Flower 在本机模拟分布式训练。数据被划分为各客户端的本地分区;客户端分别训练并返回模型参数与指标,服务器通过基于 FedAvg 的自定义策略聚合更新,保存全局模型并记录训练准确率和损失。
小组阶段的启动脚本运行一个服务器和五个客户端进程。训练结束后,我们用独立、未参与训练的测试集评估全局模型,以交叉熵损失衡量预测误差,以分类准确率衡量识别效果。这是本地多进程模拟,不代表已经完成真实多设备部署。
PPT 中的 CIFAR-10 非 IID 实验是小组阶段另一项探索,关注数据分布不均衡和本地训练配置;它与这里展示的口罩识别训练记录分开,不作为口罩识别结果引用。
02 / 我的贡献
贯通数据、训练、评估与本地预测。
根据小组汇报的 Division of Work(第 21 页),我负责训练与测试数据的收集和处理,以及口罩识别联邦训练流程的主要代码实现,并承担分布式训练实现部分的汇报。这些工作是团队协作中的主要贡献,而不是对整个小组成果的独占归属。
数据准备与模型
我收集并处理训练数据和测试数据,组织佩戴口罩/未佩戴口罩两类图像;实现 dataset.py 的数据加载与客户端等分逻辑,以及 model.py 中的轻量 CNN,为本地训练和独立测试准备一致的输入流程。
客户端训练与服务器聚合
我主要实现 client.py 和 server.py:客户端通过 Flower 的 NumPyClient 加载本地数据、训练并返回参数和指标;服务器使用基于 FedAvg 的策略聚合模型更新,按轮保存全局模型、记录准确率和损失,并在训练结束后生成曲线。
实验启动与模型评估
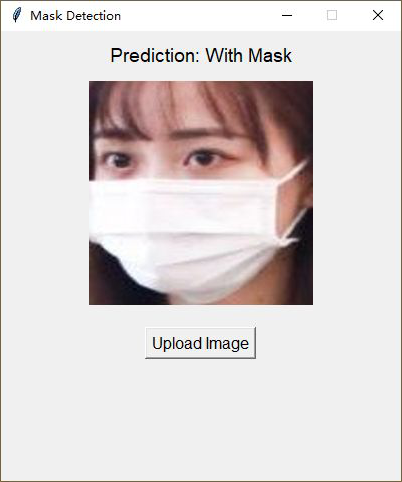
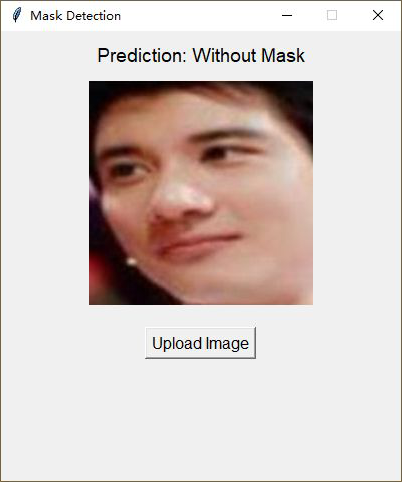
我实现 run_all.py 来启动服务器和多个带不同 CLIENT_ID 的客户端进程,串联本地模拟流程;实现 evaluate_model.py,在独立测试集上计算交叉熵损失和分类准确率,检查全局模型对未见图像的识别效果。
03 / 后续论文
从单次训练流程到配置权衡研究。
在小组项目基础上,我独立撰写了论文《Federated Learning on Mask recognition with its local simulation and optimization》,研究客户端数量与本地训练轮数(local epochs)不同组合下的模型表现。这里的本地训练轮数指客户端每次参与聚合前的训练遍数,与服务器的聚合轮次不同。
结合项目 README,后续分析用 Pareto 前沿呈现准确率与训练耗时之间的权衡:关注无法在不牺牲另一项指标的前提下继续改进的配置,而不是只按最高准确率排序。统计比较使用 Friedman 检验,并通过 Nemenyi 检验比较配置间的差异。这里说明分析方法,不引用缺少明确出处的最优组合、显著性结论或具体实验数值。
期刊页面显示论文已于 2025 年 10 月 23 日发表,收录于 STECEP,第 3 卷第 5 期,作者为 Liukai Tang。论文状态以期刊页面为准;项目 README 中的 “Under Review” 是较早的记录。
04 / 项目链接